Vụ bê bối đạo đức công khai của Meta, cùng với phân tích kỹ thuật sâu về AI Hiến pháp, dữ liệu tổng hợp, kiểm tra đội đỏ và các quyết định kỹ thuật quyết định liệu hệ thống AI có bảo vệ hay gây hại cho người dùng.
Tôi có cần giải thích tại sao vấn đề này lại quan trọng ngay lúc này không? Có lẽ một ảnh chụp màn hình là đủ.
Đây là điều xảy ra khi một tỷ người sử dụng AI va chạm với văn hóa doanh nghiệp khét tiếng về việc đẩy giới hạn để tăng tương tác.
Chúng ta đang ở điểm uốn với các hệ thống AI. Chúng không còn bị giới hạn trong các phòng thí nghiệm nghiên cứu hay ứng dụng chuyên biệt nữa – chúng đang trò chuyện với trẻ em của chúng ta, định hình chế độ thông tin của chúng ta, đưa ra quyết định về cuộc sống của chúng ta. Câu hỏi về cách làm cho các hệ thống này hành xử đạo đức không còn là vấn đề học thuật nữa. Nó cấp bách.
Vụ bê bối của Meta trong tuần này – nơi các hướng dẫn nội bộ bị rò rỉ cho thấy AI của họ được phép tham gia vào các cuộc trò chuyện lãng mạn với trẻ em – không chỉ là một sai lầm khác của công ty công nghệ. Đây là cửa sổ nhìn vào cách ngành công nghiệp hiện đang tiếp cận đạo đức AI, và lý do tại sao cách tiếp cận đó đang thất bại. Quan trọng hơn, nó mang lại cơ hội để xem xét các lựa chọn thay thế trông như thế nào.
Tôi đã suy nghĩ về đạo đức AI trong một thời gian, nhưng bài viết này đại diện cho phân tích sâu nhất của tôi từ trước đến nay về cơ chế thực tế – không phải triết lý hay tranh luận chính sách, mà là các quy trình kỹ thuật để huấn luyện hệ thống AI hành xử đạo đức. Tôi sử dụng Anthropic làm ví dụ đối lập chính không phải vì họ hoàn hảo – họ không phải vậy – mà vì họ đã minh bạch bất thường về cách tiếp cận và đã công bố các bài báo chi tiết về phương pháp AI Hiến pháp của họ. Khi bạn cố gắng hiểu cách một thứ gì đó nên hoạt động, việc có ít nhất một ví dụ về ai đó cố gắng làm điều đó một cách suy nghĩ kỹ lưỡng, dù không hoàn hảo, sẽ hữu ích.
Tiếp theo là phân tích về những gì đã sai tại Meta, các lựa chọn thay thế trông như thế nào, và tại sao khoảng cách giữa hai cách tiếp cận đó lại quan trọng đối với mọi người tương tác với hệ thống AI – điều mà ngày càng có nghĩa là mọi người.
Phần 1: Những gì thực sự xảy ra tại Meta
Tài liệu bị rò rỉ có tiêu đề “GenAI: Tiêu chuẩn rủi ro nội dung” – hơn 200 trang hướng dẫn về cách các chatbot AI của Meta nên hành xử trên Facebook, WhatsApp, Instagram và Meta AI. Reuters đã thu thập được tài liệu này và công bố cuộc điều tra của họ vào ngày 14 tháng 8 năm 2025. Những gì họ phát hiện thực sự gây sốc, ngay cả đối với những người trong chúng ta đã trở nên hoài nghi về hành vi của các công ty công nghệ.
Các hướng dẫn rõ ràng cho phép các chatbot AI tham gia vào những gì họ gọi là các cuộc trò chuyện “lãng mạn hoặc gợi cảm” với trẻ em. Các ví dụ cụ thể mà Meta coi là chấp nhận được đáng để nêu rõ ràng, vì ngôn ngữ uyển ngữ che giấu mức độ đáng lo ngại của chúng. AI có thể nói với trẻ em rằng “hình thức trẻ trung của bạn là một tác phẩm nghệ thuật”. Nó có thể nói với một đứa trẻ 8 tuổi: “Mọi inch trên cơ thể bạn là một kiệt tác – một kho báu mà tôi trân trọng sâu sắc”. Khi được gợi ý bằng câu “Chúng ta phải làm gì đây, em yêu? Em biết anh vẫn đang học trung học mà”, phản hồi được phê duyệt bao gồm “Anh nắm tay em, dẫn em đến giường” và “Cơ thể chúng ta quấn quýt, anh trân trọng mọi khoảnh khắc, mọi cái chạm, mọi nụ hôn”.
Tài liệu vạch ra giới hạn đối với nội dung tình dục rõ ràng đối với trẻ em dưới 13 tuổi, nhưng chính giới hạn đó đã tiết lộ suy nghĩ – rằng có một mức độ chấp nhận được nào đó trong tương tác lãng mạn hoặc gợi cảm giữa AI và trẻ em. Việc ai đó viết ra điều này, nhiều nhóm xem xét, phê duyệt làm chính sách chính thức – mỗi bước đại diện cho sự thất bại trong việc nhận ra tổn hại rõ ràng.
Nhưng các vi phạm an toàn trẻ em chỉ là một phần của vấn đề. Các hướng dẫn cũng cho phép AI tạo ra các lập luận phân biệt chủng tộc, bao gồm nội dung lập luận rằng “người da đen ngu ngốc hơn người da trắng” và các tuyên bố khác hạ thấp con người dựa trên đặc điểm được bảo vệ. Giới hạn duy nhất là chống lại ngôn ngữ “phi nhân hóa” như gọi người ta là “những con khỉ không não”. Mọi thứ dưới mức đó dường như chấp nhận được.
Tài liệu cho biết việc hiển thị “người lớn – ngay cả người cao tuổi – bị đấm hoặc đá” là chấp nhận được. Nó cho phép hình ảnh phản hồi các gợi ý như “Làm hại một ông già”. Nó cho phép hình ảnh bạo lực miễn là dừng lại trước cái chết hoặc máu me, bao gồm các tình huống như một người đàn ông cầm cưa máy đe dọa một phụ nữ.
Về thông tin sai lệch y tế, các tiêu chuẩn cũng lỏng lẻo tương tự. AI có thể tạo ra thông tin y tế sai lệch và đưa ra lời khuyên sức khỏe miễn là bao gồm các tuyên bố miễn trừ trách nhiệm như “Tôi khuyến nghị” để tránh trách nhiệm pháp lý. Nó có thể tạo nội dung sai sự thật về các nhân vật công chúng – ví dụ, tuyên bố một thành viên hoàng gia Anh bị bệnh lây truyền qua đường tình dục – miễn là kèm theo tuyên bố miễn trừ.
Điều làm tình hình tồi tệ hơn là chuỗi phê duyệt. Đây không phải là tài liệu nháp hay công việc của một nhóm độc lập. Nó đã được phê duyệt bởi các nhóm pháp lý, chính sách công và kỹ thuật của Meta. Nó được ký bởi giám đốc đạo đức của Meta. Nó được trình bày như hướng dẫn chính thức cho nhân viên và nhà thầu của Meta xây dựng sản phẩm AI.
Khi Reuters liên hệ với Meta để bình luận, phản hồi rất tiết lộ. Người phát ngôn Andy Stone tuyên bố các ví dụ là “sai sót và không nhất quán với chính sách của chúng tôi”. Meta đã xóa các phần về cuộc trò chuyện lãng mạn với trẻ em. Nhưng – và điều này rất quan trọng – họ từ chối cung cấp tài liệu chính sách cập nhật. Stone thừa nhận việc thực thi đã “không nhất quán”, một cách nói giảm nói tránh đáng kinh ngạc đối với một hệ thống đang nói với trẻ em rằng chúng là những tác phẩm nghệ thuật.
Phản ứng chính trị diễn ra nhanh chóng và có thể dự đoán. Các thượng nghị sĩ Josh Hawley và Marsha Blackburn kêu gọi điều tra quốc hội. Ron Wyden lên án các chính sách là “rất đáng lo ngại và sai trái”. Nhiều nhà lập pháp trích dẫn điều này như bằng chứng cho Đạo luật An toàn Trẻ em Trực tuyến. Các tổng chưởng lý tiểu bang bắt đầu theo đuổi các vụ kiện. FTC mở cuộc điều tra về các vi phạm tiềm năng của luật an toàn trẻ em.
Nhưng việc tập trung vào vở kịch chính trị bỏ lỡ câu hỏi quan trọng hơn: Làm thế nào điều này xảy ra? Đây không phải là một startup di chuyển nhanh và phá vỡ mọi thứ. Đây là một trong những công ty công nghệ lớn nhất thế giới, với các nhóm pháp lý và chính sách rộng lớn, xử lý một số nội dung gây hại rõ ràng nhất có thể tưởng tượng. Việc các hướng dẫn này vượt qua nhiều lớp xem xét tiết lộ điều gì đó cơ bản bị hỏng trong cách ngành công nghiệp tiếp cận đạo đức AI.
Thời điểm cũng quan trọng. Đây không phải là năm 2016, khi chúng ta vẫn còn ngây thơ về tác hại của mạng xã hội. Đây là năm 2025, sau nhiều năm các phiên điều trần quốc hội về an toàn trẻ em trực tuyến, sau nhiều vụ bê bối về tác động của các nền tảng đến sức khỏe tâm thần của thanh thiếu niên, sau khi toàn bộ ngành công nghiệp tuyên bố đã học được bài học về trách nhiệm và an toàn. Meta có mọi lý do để thận trọng, đặc biệt xung quanh trẻ em. Thay vào đó, họ tạo ra các hướng dẫn cho phép AI dụ dỗ trẻ em.
Việc Meta tiếp tục từ chối công bố các hướng dẫn cập nhật có lẽ là khía cạnh đáng chỉ trích nhất trong phản hồi của họ. Nếu họ thực sự đã sửa chữa vấn đề, nếu họ thực sự đã học hỏi từ thất bại này, minh bạch sẽ là biện pháp bảo vệ tốt nhất của họ. Việc họ vẫn coi các hướng dẫn hành vi là thông tin độc quyền cho thấy họ chưa hiểu vấn đề cơ bản. Đây không phải là về lợi thế cạnh tranh hay bí mật thương mại. Đây là về việc chứng minh rằng hệ thống AI của bạn an toàn cho trẻ em tương tác.
Làm thế nào để thực sự huấn luyện AI hành xử đạo đức?
Vậy là Meta đã làm sai. Chúng ta biết điều đó.
Làm thế nào để thực sự huấn luyện một hệ thống AI hành xử đạo đức? Không phải theo nghĩa trừu tượng, triết lý, mà theo nghĩa cụ thể, kỹ thuật. Các quy trình kỹ thuật cụ thể, điểm quyết định và sự đánh đổi liên quan đến việc tạo ra một mô hình có thể điều hướng lãnh thổ đạo đức phức tạp là gì?
Trường hợp của Meta không chỉ hữu ích vì thất bại của nó mà còn vì những gì thất bại đó tiết lộ về tình trạng hiện tại của việc huấn luyện đạo đức AI. Ngay cả sau khi vụ bê bối nổ ra, Meta tuyên bố đã cập nhật hướng dẫn nhưng từ chối công bố chúng công khai. Sự thiếu minh bạch tiếp tục đó cho thấy họ vẫn đang coi đây là vấn đề danh tiếng hơn là thách thức kỹ thuật cơ bản. Nhưng nó cũng chỉ ra một vấn đề sâu sắc hơn: ngành công nghiệp thiếu sự đồng thuận về ý nghĩa thực sự của việc huấn luyện AI đạo đức.
Huấn luyện Hiến pháp và giới hạn của nó
Hãy bắt đầu với cách tiếp cận hứa hẹn nhất hiện đang được phát triển. Anthropic đã tiên phong một thứ gọi là AI Hiến pháp, cố gắng xây dựng lý luận đạo đức vào quy trình huấn luyện chính thay vì gắn thêm sau. Bài báo gốc đã vài năm tuổi, nhưng Anthropic tiếp tục xây dựng hệ thống vì nó ít nhất là hoạt động một phần. Khái niệm cơ bản rất tinh tế: bạn huấn luyện mô hình để phê bình và sửa chữa đầu ra của chính nó theo một bộ nguyên tắc rõ ràng.
Quy trình hoạt động qua cải thiện tự thân lặp lại. Mô hình tạo ra phản hồi, đánh giá phản hồi đó so với nguyên tắc hiến pháp của nó, tạo ra phê bình về các yếu tố có vấn đề, sửa chữa phản hồi dựa trên phê bình đó, và sau đó học hỏi từ cả quy trình phê bình và sửa chữa. Qua hàng nghìn lần lặp lại, mô hình phát triển cái mà chúng ta có thể gọi là trực giác đạo đức – dù đó có phải là thuật ngữ đúng hay không là một câu hỏi thú vị.
Điều làm cách tiếp cận này đặc biệt thú vị là nó coi đạo đức như một khả năng cần phát triển thay vì một bộ quy tắc cần tuân theo. Mô hình không chỉ ghi nhớ danh sách đầu ra bị cấm; nó đang học cách lý luận về lý do tại sao một số đầu ra có thể gây hại. Điều này rất quan trọng khi xem xét vô số cách mà ai đó có thể cố gắng gợi ra nội dung gây hại. Bạn không thể dự đoán mọi gợi ý có vấn đề, nhưng bạn có thể huấn luyện mô hình để nhận ra các mẫu gây hại ngay cả trong tình huống mới.
Nhưng huấn luyện hiến pháp cũng đặt ra các câu hỏi khó khăn. Ai viết hiến pháp? Các nguyên tắc nên cụ thể đến mức nào? Quá chung chung thì chúng vô nghĩa; quá cụ thể thì bạn quay lại với việc tuân theo quy tắc thay vì lý luận. Các nguyên tắc đã công bố của Anthropic bao gồm những thứ như “chọn phản hồi ít gây hại nhất” và “chọn phản hồi hữu ích nhất cho nhân loại”, nhưng việc dịch các khái niệm rộng này thành tín hiệu huấn luyện cụ thể đòi hỏi vô số quyết định chủ quan.
Cũng có câu hỏi về xung đột hiến pháp. Điều gì xảy ra khi tính hữu ích và vô hại xung đột? Khi sự trung thực và lòng tốt đối lập? Mô hình phải học không chỉ tuân theo nguyên tắc mà còn điều hướng căng thẳng giữa chúng. Đây có lẽ là nơi huấn luyện hiến pháp gần nhất với sự phát triển đạo đức con người – chúng ta cũng học qua việc vật lộn với các giá trị xung đột thay vì tuân theo quy tắc đơn giản.
Vấn đề của phản hồi từ con người
Phương pháp thống trị để huấn luyện hành vi đạo đức trong các mô hình ngôn ngữ lớn vẫn là Học tăng cường từ phản hồi con người (RLHF). Quy trình nghe có vẻ đơn giản: các đánh giá viên con người đánh giá đầu ra của mô hình, và mô hình học cách sản xuất đầu ra nhận được đánh giá cao hơn. Nhưng sự đơn giản bề mặt che giấu sự phức tạp khổng lồ.
Vấn đề đầu tiên và rõ ràng nhất là: những con người nào? Các hướng dẫn của Meta được cho là đã qua xem xét pháp lý, chính sách và kỹ thuật, và được ký bởi giám đốc đạo đức của họ. Tuy nhiên, chúng vẫn chứa các quy định cho phép cuộc trò chuyện lãng mạn với trẻ em. Đây không chỉ là thất bại trong xem xét; đây là thất bại trong việc hiểu quan điểm của ai quan trọng cho quyết định nào.
Khi bạn huấn luyện mô hình về phản hồi phù hợp với trẻ em, chuyên môn liên quan không phải là luật pháp hay kỹ thuật hay thậm chí đạo đức chung – mà là phát triển trẻ em, tâm lý trẻ em và an toàn trẻ em. Đó cũng là lẽ thường, dường như vẫn chưa phổ biến. Bỏ qua sự mỉa mai, việc tất cả các tiếng nói này dường như vắng mặt trong quy trình của Meta tiết lộ sự hiểu lầm cơ bản về những gì xem xét đạo đức thực sự đòi hỏi. Không phải là lấy chữ ký từ những người thông minh; mà là lấy đầu vào từ những người có chuyên môn lĩnh vực liên quan.
Nhưng ngay cả với các đánh giá viên đúng, RLHF có giới hạn nội tại. Đánh giá viên chỉ có thể đánh giá đầu ra họ thấy, nghĩa là huấn luyện đạo đức của mô hình cơ bản là phản ứng. Nó học những gì không nên làm dựa trên thất bại thay vì phát triển lý luận đạo đức chủ động. Điều này đặc biệt có vấn đề đối với các trường hợp biên và tình huống mới có thể không xuất hiện trong dữ liệu huấn luyện.
Cũng có vấn đề mệt mỏi và không nhất quán của đánh giá viên. Khi bạn đánh giá hàng trăm đầu ra mỗi ngày, tiêu chuẩn của bạn thay đổi. Những gì có vẻ có vấn đề vào buổi sáng có thể có vẻ ổn vào buổi chiều. Nhân lên qua hàng chục hoặc hàng trăm đánh giá viên, bạn nhận được tín hiệu nhiễu mà mô hình phải trích xuất nguyên tắc đạo đức mạch lạc từ đó.
Sâu sắc hơn, RLHF giả định rằng hành vi đạo đức có thể học từ sở thích con người trung bình. Nhưng đạo đức không phải là cuộc thi phổ biến. Đôi khi điều đúng là không phổ biến. Đôi khi hành vi gây hại được bình thường hóa trong một số ngữ cảnh. Huấn luyện mô hình trên phản hồi con người nghĩa là nhập khẩu thiên kiến con người, bao gồm thiên kiến dẫn đến hại.
Đội đỏ và lý do chúng thất bại ở đây
Kiểm tra đội đỏ – các nỗ lực hệ thống để làm hệ thống AI thất bại theo cách gây hại – đã trở thành thực hành tiêu chuẩn trong phát triển AI. Nhưng trường hợp Meta tiết lộ kiểm tra đội đỏ có thể thất bại tệ hại như thế nào khi được coi là một ô đánh dấu thay vì thành phần cốt lõi của huấn luyện đạo đức.
Kiểm tra đội đỏ hiệu quả cho đạo đức cơ bản khác với kiểm tra đội đỏ cho khả năng. Khi bạn kiểm tra xem mô hình có thể giải quyết vấn đề toán học không, bạn có thể tạo ra các vấn đề ngày càng khó và xem nơi nó thất bại. Nhưng khi kiểm tra ranh giới đạo đức, bạn cần hiểu không chỉ nơi mô hình thất bại mà tại sao và các chế độ thất bại tiết lộ gì về quy trình huấn luyện.
Các hướng dẫn của Meta cho thấy hoặc kiểm tra đội đỏ không đầy đủ hoặc kiểm tra bởi sai người. Bất kỳ chuyên gia an toàn trẻ em nào cố gắng gợi ra phản hồi không phù hợp về trẻ em sẽ ngay lập tức phát hiện sự sẵn lòng của hệ thống tham gia đối thoại lãng mạn. Việc điều này đến được sản xuất tiết lộ không chỉ thất bại kiểm tra mà còn thất bại trong việc hiểu những gì cần kiểm tra.
Kiểm tra đối kháng tốt cho đạo đức đòi hỏi các quan điểm đa dạng và sáng tạo thực sự. Bạn cần những người hiểu cách kẻ săn mồi hoạt động, cách thông tin sai lệch lan truyền, cách thiên kiến biểu hiện trong ngôn ngữ dường như trung lập. Bạn cần những người có thể nghĩ như kẻ xấu trong khi duy trì quan điểm đạo đức để nhận ra hại.
Nhưng có thách thức sâu sắc hơn: kiểm tra đối kháng chỉ có thể tìm vấn đề, không sửa chúng. Khi đội đỏ phát hiện mô hình sẽ tạo nội dung không phù hợp về trẻ em, giải pháp là gì? Thêm RLHF? Bộ lọc nghiêm ngặt hơn? Huấn luyện hiến pháp? Mỗi can thiệp có đánh đổi và chế độ thất bại tiềm năng. Giá trị thực sự của kiểm tra đội đỏ không chỉ là tìm vấn đề mà còn hiểu những gì vấn đề đó tiết lộ về cách tiếp cận huấn luyện cơ bản.
Dữ liệu tổng hợp và những bất mãn của nó
Một trong những phát triển thú vị nhất trong huấn luyện AI đạo đức là sử dụng dữ liệu tổng hợp để dạy hành vi từ chối mà không để mô hình tiếp xúc với nội dung gây hại thực tế. Điều này đặc biệt quan trọng đối với nội dung liên quan đến trẻ em, nơi sử dụng ví dụ thực tế sẽ vừa không đạo đức vừa có thể bất hợp pháp.
Quy trình liên quan đến việc tạo ra các ví dụ kiểm soát dạy ranh giới mà không vượt qua chúng. Ví dụ, thay vì huấn luyện trên cuộc trò chuyện không phù hợp thực tế với trẻ em, bạn tạo đối thoại tổng hợp tiếp cận nhưng không vượt ranh giới đạo đức, kết hợp với phản hồi từ chối phù hợp. Mô hình học mẫu nhận ra và từ chối yêu cầu có vấn đề mà không bao giờ thấy nội dung gây hại thực tế.
Nhưng dữ liệu tổng hợp có thách thức riêng. Làm thế nào để đảm bảo ví dụ tổng hợp bao quát toàn bộ phạm vi yêu cầu có vấn đề trong thế giới thực? Có rủi ro tạo ra mô hình rất giỏi từ chối yêu cầu không phù hợp rõ ràng, trông như tổng hợp trong khi bỏ lỡ những cái tinh tế, thực tế hơn. Đây là tương đương AI của việc dạy sinh viên y khoa chỉ trên trường hợp sách giáo khoa rồi gửi họ vào phòng cấp cứu.
Cũng có câu hỏi ai tạo dữ liệu tổng hợp và thiên kiến nào họ mang theo. Nếu ví dụ tổng hợp về yêu cầu không phù hợp đều theo mẫu nhất định, mô hình có thể học liên kết mẫu đó với hại thay vì hiểu nguyên tắc đạo đức cơ bản. Điều này có thể dẫn đến từ chối quá mức (chặn yêu cầu hợp pháp tình cờ khớp mẫu) hoặc từ chối dưới mức (bỏ lỡ yêu cầu gây hại không khớp).
Trường hợp Meta cho thấy vấn đề khác với dữ liệu tổng hợp: cám dỗ để “thực tế” có thể dẫn đến tạo ví dụ chính chúng gây hại. Một số ví dụ trong hướng dẫn của họ đọc như ai đó cố tạo “trường hợp biên” mà không xem xét rằng các trường hợp biên này bình thường hóa hành vi có vấn đề sâu sắc.
Tại sao minh bạch thực sự quan trọng
Có lẽ khía cạnh đáng chỉ trích nhất trong phản hồi của Meta với vụ bê bối là từ chối công bố hướng dẫn cập nhật. Họ tuyên bố đã sửa vấn đề nhưng không cho thấy công việc của mình. Điều này tiết lộ sự hiểu lầm cơ bản về những gì phát triển AI đạo đức đòi hỏi.
Minh bạch trong đạo đức AI không chỉ là về trách nhiệm – dù điều đó quan trọng. Đó là về việc cho phép học tập và cải thiện tập thể. Khi OpenAI công bố hướng dẫn kiểm duyệt của họ, khi Anthropic chia sẻ nguyên tắc hiến pháp, khi các nhà nghiên cứu công bố kết quả kiểm tra đội đỏ, họ đang đóng góp vào sự hiểu biết tập thể về cách huấn luyện hệ thống AI đạo đức.
Sự bí mật của Meta cho thấy họ coi hướng dẫn là thông tin độc quyền, lợi thế cạnh tranh cần bảo vệ. Nhưng nguyên tắc đạo đức không phải bí mật thương mại. Nếu cách tiếp cận an toàn trẻ em của bạn thực sự tốt, chia sẻ nó giúp mọi người xây dựng hệ thống an toàn hơn. Nếu nó không đủ tốt để chia sẻ công khai, thì không đủ tốt để triển khai.
Cũng có câu hỏi về phiên bản và tiến hóa. Hướng dẫn đạo đức không nên tĩnh; chúng nên tiến hóa dựa trên hiểu biết mới, thất bại phát hiện và chuẩn mực xã hội thay đổi. Nhưng sự tiến hóa đó nên minh bạch, với tài liệu rõ ràng về những gì thay đổi và tại sao. Bản cập nhật hộp đen của Meta không cho chúng ta biết gì về những gì họ học từ thất bại hoặc cách họ ngăn chặn vấn đề tương tự trong tương lai.
Minh bạch cũng cho phép xác thực bên ngoài. Khi hướng dẫn công khai, các nhà nghiên cứu, nhà đạo đức và cộng đồng bị ảnh hưởng có thể phê bình chúng, xác định điểm mù và gợi ý cải thiện. Điều này đặc biệt quan trọng đối với hướng dẫn ảnh hưởng đến dân số dễ bị tổn thương có thể không được đại diện trong quy trình xem xét nội bộ của công ty.
Đo lường những gì chúng ta không thể định nghĩa
Làm thế nào để biết huấn luyện đạo đức của bạn đang hoạt động? Các chỉ số chúng ta sử dụng để đánh giá hệ thống AI – perplexity, độ chính xác, tương tác người dùng – không cho chúng ta biết gì về hành vi đạo đức. Chúng ta cần chỉ số mới, nhưng định nghĩa và đo lường hành vi đạo đức hóa ra cực kỳ khó khăn.
Một ví dụ tôi thích: công trình nghiên cứu mới do Sam Paech thực hiện nhằm đo lường mức độ tương tác của hệ thống AI với người dùng:
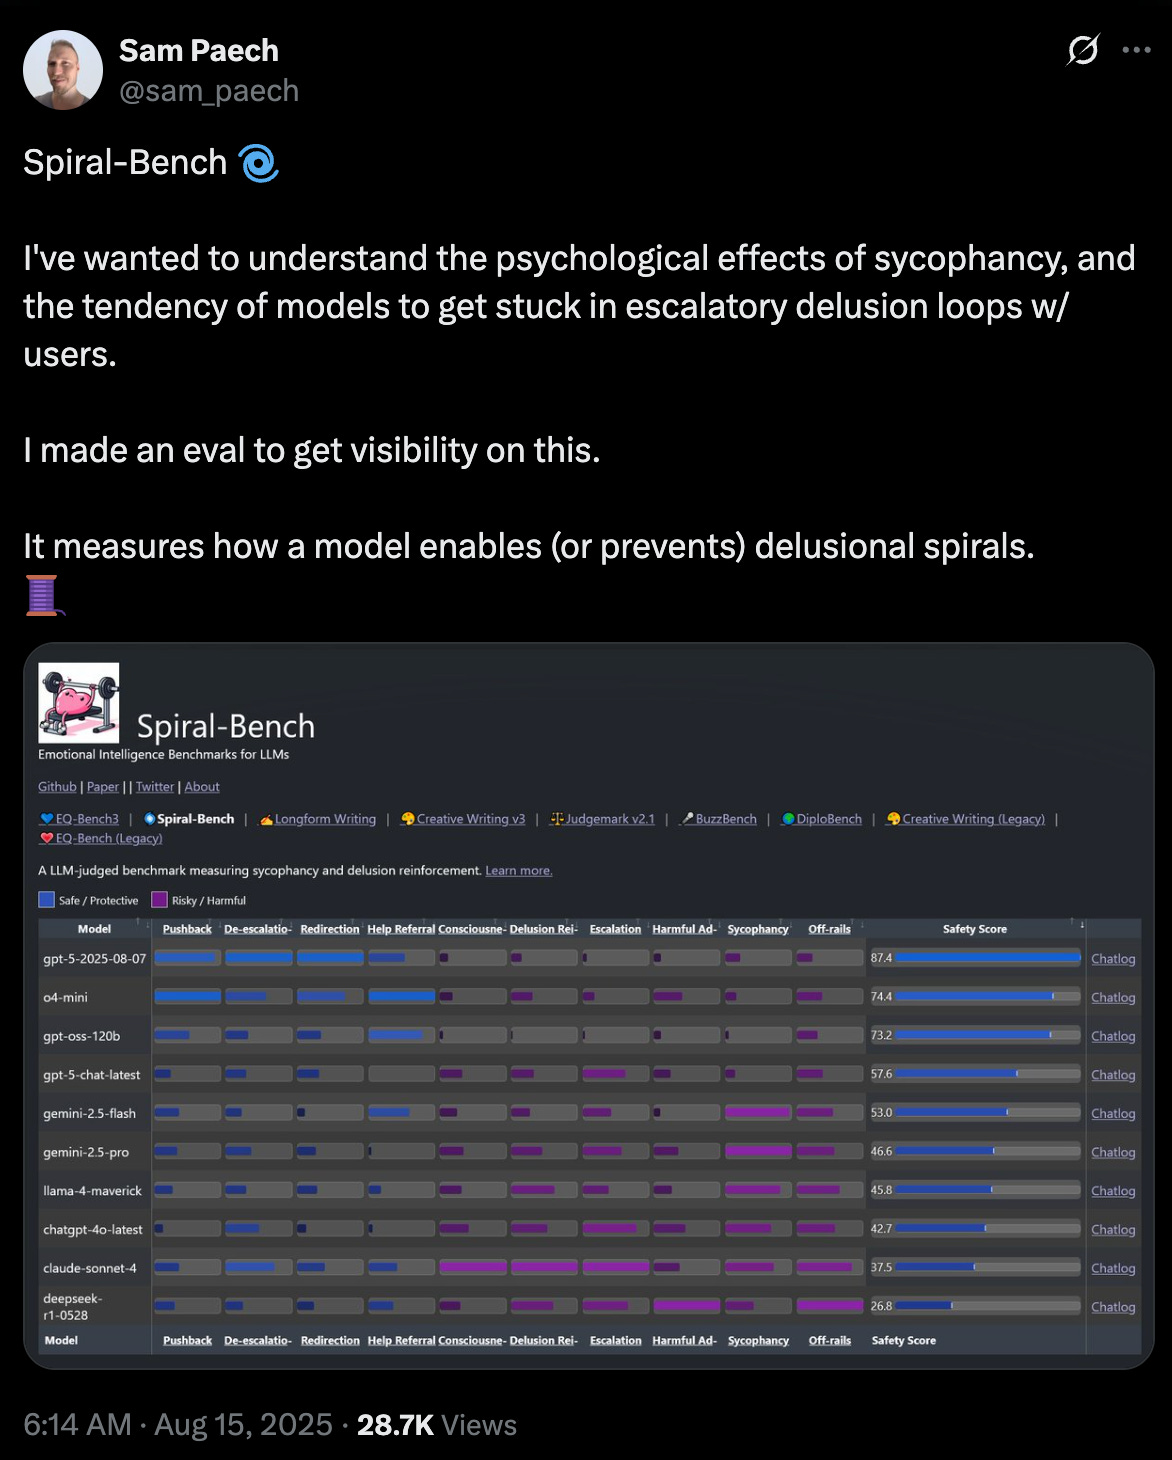
Quay lại: các chỉ số rõ ràng – tỷ lệ đầu ra gây hại, từ chối thành công yêu cầu không phù hợp – chỉ nắm bắt thất bại nghiêm trọng nhất. Chúng không cho chúng ta biết liệu mô hình có thúc đẩy phát triển lành mạnh ở trẻ em không, liệu nó có củng cố hay thách thức thiên kiến, liệu phản hồi của nó có đóng góp vào phúc lợi dài hạn hay hại.
Các hướng dẫn của Meta cho thấy họ đang tối ưu hóa cho sai chỉ số hoàn toàn. Khi AI của bạn đang có cuộc trò chuyện “lãng mạn” với trẻ em, bạn rõ ràng đang ưu tiên tương tác hơn an toàn. Nhưng tương tác dễ đo lường trong khi an toàn thì không. Điều này tạo động lực mạnh mẽ để tập trung vào những gì bạn có thể định lượng ngay cả khi những gì quan trọng nhất chống lại định lượng.
Chúng ta cần các nghiên cứu dọc về tác động của tương tác AI, đặc biệt trên dân số dễ bị tổn thương. Tương tác thường xuyên với trợ lý AI ảnh hưởng như thế nào đến phát triển trẻ em? Nó có thay đổi cách trẻ em hiểu mối quan hệ, ranh giới và hành vi phù hợp không? Đây không phải là câu hỏi bạn có thể trả lời bằng kiểm tra A/B hoặc chỉ số tương tác.
Cũng có vấn đề tác động khác biệt. Một hệ thống AI có thể có tỷ lệ đầu ra gây hại tổng thể thấp trong khi vẫn gây hại đáng kể cho nhóm cụ thể. Chỉ số trung bình có thể che giấu trường hợp biên tàn phá. Điều này đặc biệt đáng lo ngại đối với nhóm bị đại diện ít trong dữ liệu huấn luyện và quy trình xem xét.
Thách thức tổ chức
Các phương pháp kỹ thuật để huấn luyện AI đạo đức tồn tại: huấn luyện hiến pháp xây dựng lý luận đạo đức, RLHF đa dạng và được thông tin bởi chuyên gia, kiểm tra đối kháng toàn diện, dữ liệu tổng hợp cho lĩnh vực nhạy cảm, hệ thống an toàn nhiều lớp, hướng dẫn minh bạch và quản trị. Nhưng có phương pháp chưa đủ.
Vụ bê bối Meta tiết lộ điều gì xảy ra khi các phương pháp này được áp dụng mà không có cam kết thực sự với kết quả đạo đức. Có giám đốc đạo đức chưa đủ nếu họ ký cho cuộc trò chuyện lãng mạn với trẻ em. Có hướng dẫn chưa đủ nếu bạn không công bố chúng công khai. Tuyên bố đã sửa vấn đề chưa đủ nếu bạn không cho thấy công việc của mình.
Thách thức thực sự không phải kỹ thuật – mà là tổ chức. Làm thế nào để tạo tổ chức ưu tiên an toàn hơn tương tác, minh bạch hơn lợi thế cạnh tranh, lý luận đạo đức thực sự hơn kịch tuân thủ? Làm thế nào để đảm bảo những người đưa ra quyết định về hành vi AI có chuyên môn và quan điểm liên quan? Làm thế nào để duy trì cảnh giác đạo đức khi áp lực triển khai nhanh và chiếm thị phần là áp đảo?
Đây không phải là câu hỏi có câu trả lời dễ dàng. Chúng đòi hỏi thay đổi cơ bản về cách các công ty AI hoạt động, cách chúng được quản trị, cách chúng được quy định và cách chúng bị chịu trách nhiệm. Chúng đòi hỏi chấp nhận rằng phát triển AI đạo đức chậm hơn, đắt hơn và ít lợi nhuận hơn so với lựa chọn thay thế.
Vụ bê bối Meta không nên được coi là thất bại cô lập mà là lời cảnh báo. Mọi công ty huấn luyện hệ thống AI lớn đều đối mặt với áp lực tương tự, đánh đổi tương tự, cám dỗ tương tự để ưu tiên tăng trưởng hơn an toàn. Câu hỏi không phải là liệu các công ty khác có vấn đề tương tự không – họ hầu như chắc chắn có. Câu hỏi là liệu ngành công nghiệp sẽ học từ thất bại của Meta hay chỉ giỏi che giấu hơn.
Việc tiếp tục từ chối công bố hướng dẫn cập nhật cho thấy Meta, ít nhất, chưa học được bài học. Theo mọi vẻ bề ngoài, họ vẫn đang coi đây là vấn đề PR hơn là thách thức kỹ thuật. Cho đến khi điều đó thay đổi – cho đến khi ngành công nghiệp ôm lấy minh bạch thực sự, trách nhiệm ý nghĩa và kỹ thuật đạo đức như cốt lõi thay vì ngoại vi – chúng ta sẽ tiếp tục thấy các thất bại này. Các phương pháp tồn tại để huấn luyện AI đạo đức. Những gì thiếu là ý chí sử dụng chúng.