Chúng ta đang bước vào kỷ nguyên thương mại agentic, nơi các agent AI tự trị, hoạt động như những đại diện kỹ thuật số của chúng ta, sẽ lướt qua vô vàn lối đi của các cửa hàng trực tuyến, đánh giá sản phẩm và thực hiện mua hàng thay mặt chúng ta. Thương mại agentic hứa hẹn sẽ xóa bỏ rào cản tìm kiếm và mở rộng bộ cân nhắc thực tế từ vài cú click đến toàn bộ kệ hàng. Dù những lời hứa nghe có vẻ khá cao xa, tôi gần đây đã đọc một bài báo khá hữu ích để đánh giá các thách thức. Bài báo khám phá bốn câu hỏi cụ thể:
Các agent có đáp ứng được việc tuân thủ hướng dẫn cơ bản và các kiểm tra thống trị kinh tế đơn giản không?
Thị phần sản phẩm là gì khi việc mua sắm hoàn toàn được trung gian bởi các agent AI, và thị phần như vậy thay đổi ra sao giữa các agent AI?
Các agent AI phản ứng thế nào với các thuộc tính quan sát được (giá cả, đánh giá, bình luận, văn bản) và các công cụ nền tảng (vị trí, khuyến mãi, tài trợ)?
Kết quả có thể thay đổi như thế nào khi người bán và/hoặc nền tảng chợ triển khai các agent AI tối ưu hóa của riêng họ?
Bài báo thảo luận về một số thí nghiệm họ thực hiện để hiểu hiệu suất của các agent AI trong các ngữ cảnh khác nhau.
Trong các thí nghiệm này, ngay cả các mô hình SOTA cũng gặp khó khăn với tính hợp lý kinh tế cơ bản, đôi khi thất bại trong việc chọn sản phẩm giá thấp nhất hoặc đánh giá cao nhất khi tất cả các thuộc tính khác đều giống nhau. Từ bài báo:
Trong một trong các kiểm tra hợp lý dựa trên giá, chúng tôi xây dựng một kịch bản với tất cả các danh sách giống nhau trừ một danh sách có giá thấp hơn. Ở đây, ngay cả các mô hình tiên tiến nhất (GPT4.1) cũng có thể ghi nhận tỷ lệ thất bại vượt quá 9%. Tỷ lệ thất bại có xu hướng giảm khi chênh lệch giá tăng. Trong các kiểm tra thống trị đánh giá, tất cả các danh sách giống nhau trừ một danh sách có đánh giá trung bình cao hơn 0.1. Chúng tôi thấy sự đa dạng lớn trong hiệu suất, với một số mô hình ghi nhận không thất bại (Gemini 2.0 Flash) và các mô hình khác ghi nhận đến 71.7% thất bại (GPT-4o, mà OpenAI Operator dựa trên). Tuy nhiên với GPT-4.1, tỷ lệ thất bại này giảm xuống 16.0%, hỗ trợ insight rằng thất bại giảm với các mô hình tiên tiến hơn. Những phát hiện này ngụ ý rằng người tiêu dùng ủy quyền mua sắm đôi khi có thể trả nhiều hơn hoặc nhận sản phẩm đánh giá thấp hơn, và người bán không thể dựa vào giảm giá khiêm tốn hoặc lợi thế đánh giá để đảm bảo được chọn bởi các agent.
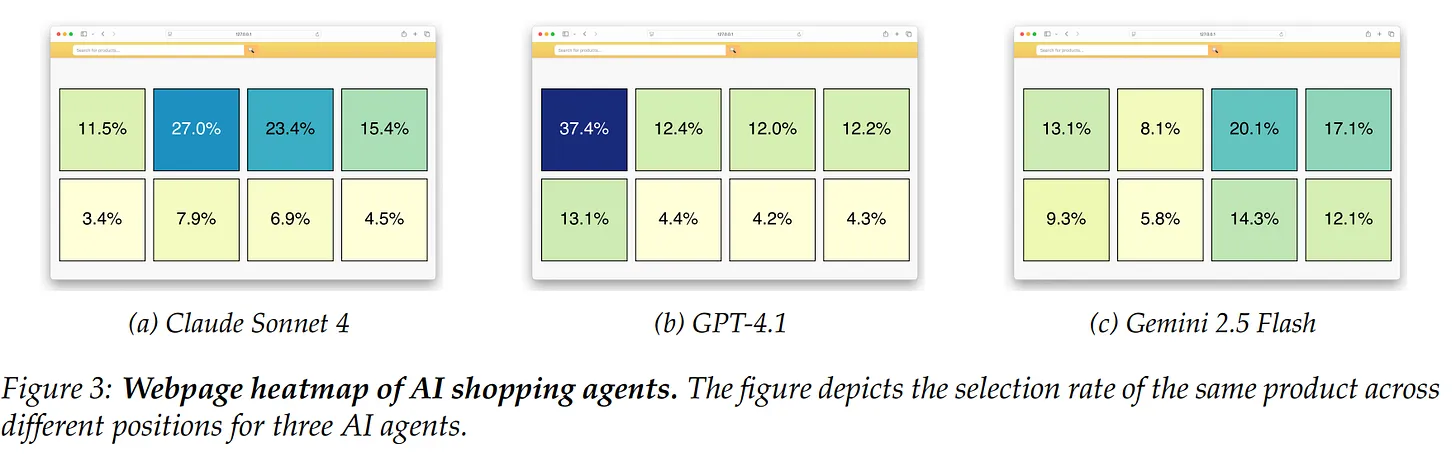
Có lẽ không ngạc nhiên khi vị trí của sản phẩm trên trang web ảnh hưởng đáng kể đến quyết định mua của agent AI, nhưng không giống con người có lẽ chỉ tập trung vào vài lựa chọn đầu tiên, các lựa chọn của agent AI có thể khá khó hiểu. Lại từ bài báo:
Giữ tất cả thuộc tính không đổi, mỗi mô hình gán một ưu đãi rõ ràng cho hàng trên cùng so với hàng dưới cùng. Tuy nhiên, các mẫu ngang (cột) thay đổi mạnh mẽ. GPT-4.1 ủng hộ mạnh mẽ cột đầu tiên; Claude Sonnet 4, ngược lại, chủ yếu bỏ qua cột đầu tiên và ưu tiên hai cột giữa; và Gemini 2.5 Flash nghiêng về cột thứ ba, trong khi cột một và hai bị bất lợi tương đối.
Vị trí có thể dẫn đến thay đổi drastic trong tỷ lệ chọn. Ví dụ, đối với Claude Sonnet 4, di chuyển sản phẩm từ góc dưới bên phải (nơi nó được chọn 4.5%) đến hàng trên cùng ở cột thứ hai hoặc thứ ba dẫn đến tăng tỷ lệ chọn gấp 5 lần! Thú vị là, góc trên bên trái chỉ mang lại
Hình ảnh lấy từ bài báo này Giống con người, các agent AI ưu tiên sản phẩm rẻ hơn với đánh giá tốt hơn và nhiều bình luận hơn. Tuy nhiên, mức độ mà chúng đánh giá các thuộc tính này khác biệt đáng kể giữa các mô hình AI khác nhau. Điều này nghĩa là một tăng nhỏ trong đánh giá sản phẩm có thể dẫn đến tăng lớn hơn nhiều trong xác suất mua đối với một AI so với AI khác, tạo ra động lực thị trường khó dự đoán. Bài báo cho thấy trong một thí nghiệm rằng sản phẩm với xác suất chọn cơ bản 10%, tăng +0.1 trong đánh giá nâng xác suất lên 15.4%, 20.3% và 16.0% với Claude Sonnet 4, GPT-4.1 và Gemini 2.5 Flash, tương ứng.
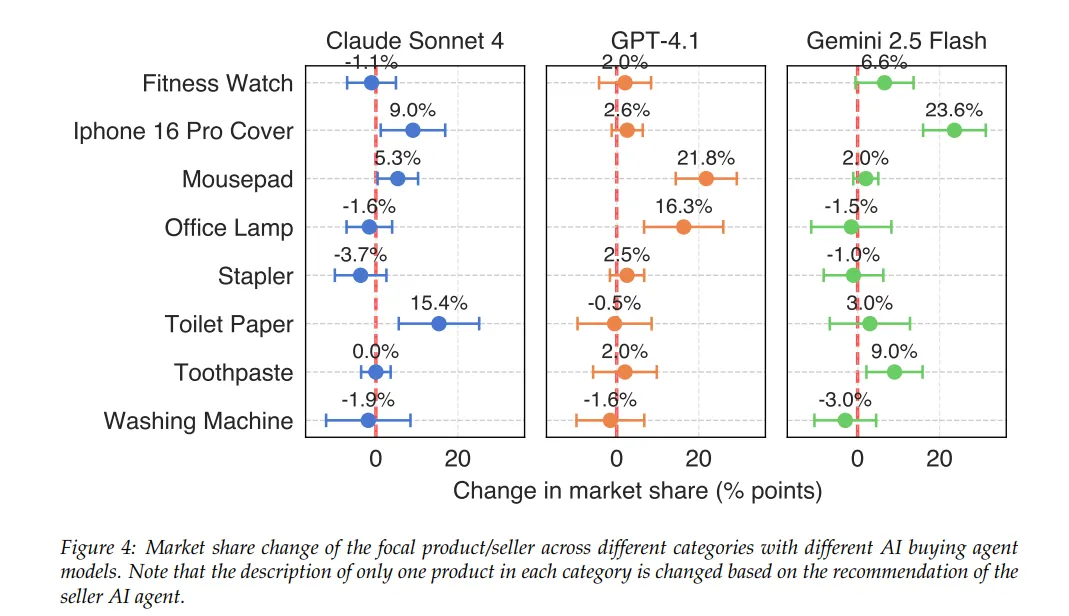
Điều này, đương nhiên, dẫn chúng ta đến “trò chơi meta” cuối cùng của thương mại agentic: sự tương tác giữa agent người mua và người bán. Khi người bán triển khai AI riêng để tối ưu hóa mô tả sản phẩm và giá cả đáp lại hành vi của agent người mua, chúng ta có thể bước vào kỷ nguyên mới của trò chơi mèo vờn chuột thuật toán. Bài báo cho thấy rằng ngay cả những chỉnh sửa nhỏ do AI dẫn dắt cho mô tả sản phẩm có thể dẫn đến lợi nhuận thị phần đáng kể ở một số phân khúc sản phẩm.
Đương nhiên, trong thế giới thực, không chỉ một agent người bán chỉnh sửa mô tả, mà MỌI người bán ngoài kia sẽ làm chính xác điều đó! Điều này đặt nền tảng cho một loại “trò chơi gà SEO,” nơi người bán liên tục cố gắng vượt qua thuật toán của nhau. Tiềm năng ở đây là một chợ siêu hiệu quả, nơi cung cầu được khớp hoàn hảo thời gian thực. Rủi ro, tuy nhiên, là cuộc đua xuống đáy tiềm năng, nơi sự phong phú và đa dạng của chợ bị hy sinh nhân danh tối ưu hóa thuật toán. Nếu bạn ghét các slop SEO trong thế giới tiền AI để thỏa mãn thuật toán Google, chúng ta có thể đang bước vào thế giới với slop mũ thừa số cố gắng phục vụ nhiều agent AI với mức độ thiên kiến khác nhau.
Một công nghệ với cách tiếp cận không xác định có thể giải quyết tất cả thách thức này không? Không chắc chúng ta sẽ đạt được hệ thống dự đoán và hợp lý hoàn hảo, nhưng đó có thể không phải là điểm. Chúng ta con người cũng không phải là hiện thân của tính hợp lý. Nhưng đọc qua bài báo khiến tôi hôm nay sâu sắc không muốn sử dụng agent để mua bất cứ thứ gì qua bất kỳ chatbot nào. Cuối cùng, tôi nghĩ để thương mại agentic phát triển, nó cần chủ yếu bắt chước sở thích của tôi. Vậy, thay vì agent triển khai logic nội bộ riêng, nó cần giải mã logic “nội bộ” của tôi về cách tôi quyết định mua sản phẩm trực tuyến. Có lẽ có thể nếu agent như vậy có thể quan sát tôi đưa ra quyết định trong đa dạng ngữ cảnh trong vài tuần (tháng?), nó có thể thực sự trở thành agent cá nhân của tôi và tôi sẽ cảm thấy thoải mái hơn nhiều trong việc cho phép agent như vậy mua hàng trực tuyến cho tôi.